主题
第 20 章 Qwen3 与 Qwen3.5:同一个名字下,两种记忆接口
Qwen3 的密集版和 MoE 版主要在前馈模块上分岔;Qwen3.5 的教学实现又引入全局注意力与 Gated DeltaNet 的混合。因此“换 checkpoint 名称”不足以完成模型替换。投影宽度、归一化参数含义、位置旋转范围、缓存种类都必须一起核对。
来源为固定提交 ch05/11_qwen3 的四份 notebook,以及 ch05/16_qwen3.5 的两份 notebook 与 helper。这里限定为源码中的文本模型,不涵盖整个系列的多模态组件。
20.1 Qwen3:Q/K 归一化发生在每个头内部
Qwen3 的主干仍是 token embedding、重复的预归一化残差块、final RMSNorm、输出头。FFN 是 SiLU 门控前馈。与 Llama 3.2 的实现相比,一个重要差别是 attention 的 qk_norm:Q/K 拆成
这不会把 Q/K 变成概率,也不是 L2 范数恒为 1:RMSNorm 除以均方根,若无缩放参数,其向量二范数约为 RMSNorm 默认 qwen3_compatible=True 时先转 float32 计算平方均值,再转回输入 dtype;scale 初始化为 1。归一化轴若错放到合并后的全部头,模型函数会改变,第 22 章 OLMo 正好展示了另一种合法但不同的选择。
head_dim 可以显式指定,不必等于 emb_dim // n_heads。例如源码 0.6B 配置的 embedding 宽度为 1024,16 个 query 头、每头 128,注意力内部总宽为 2048,最后 out_proj 再映射回 1024。实现必须用
这些具体实现点可在 GroupedQueryAttention.__init__/forward 逐项核对;更广泛的训练与评估背景见 Qwen3 技术报告,本书不复述其大规模指标。
20.2 Qwen3 MoE:注意力不变,前馈变为按 token 分派
MoE notebook 添加 MoEFeedForward,用 num_experts 个门控专家和 num_experts_per_tok 的 top-moe_hidden_dim,不能直接沿用密集模型的 hidden_dim。源码仍在选中分数上 softmax,收集输入、取各 token 的路由概率、index_add_ 合并,完整过程见第 12 章。
加载器逐层映射 router 的 gate,以及每个 expert 的 gate/up/down 三个投影。所有专家权重都要存在,虽然一个 token 只激活其中几个。calc_model_memory_size 的全参数结果不会因为 top-Qwen3Model 的外部输入输出仍为
目录四份 notebook 形成两条独立对照轴:密集/MoE、无 cache/有 cache。缓存版只改变 attention 与模型的状态协议,不会把 MoE 改成另一种路由算法。覆盖台账分别保留四份单元位置,避免把重复实现当成缺失。
20.3 Qwen3 缓存:位置计数和 KV 容器缺一不可
缓存版 KVCache 是逐层列表,get/update/get_all/reset 管理每层的 K/V 元组。attention 将新 K 先按 start_pos 旋转,再与旧 K 拼接;旧 K 已经带位置,不能再旋转。模型保存 current_pos,构造从 pos_start 开始的矩形 causal mask,并把更新后的 cache 交还容器。
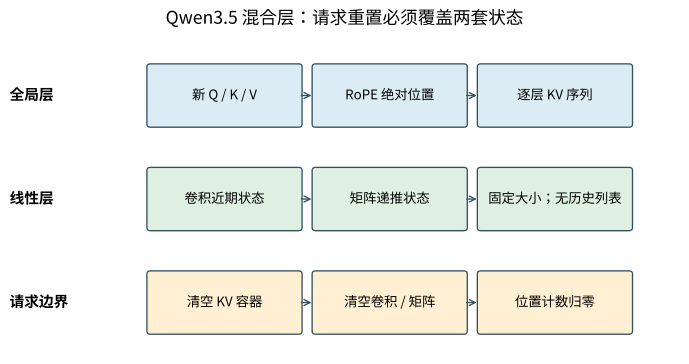
model.reset_kv_cache() 在这些 notebook 中主要重置模型位置;cache.reset() 才清空外部容器。新请求必须两者一致。生成器先用 prompt 预填充,随后只传新增 token;有上下文裁剪参数的版本到边界时清缓存重建。EOS 判断应使用当前 tokenizer 的 ID,不要把另一个模型的终止编号带进来。
generate_text_basic_stream 逐个 yield token ID,流式显示不改变因果模型的数学。tokenizer 从发布文件加载,Base/Reasoning/Instruct 的选择影响 checkpoint 与模板。推理格式的开关不意味着随机架构自己学会推理;这来自具体训练过的参数与输入协议。
20.4 Qwen3.5 的全局层:局部旋转与额外输出门
Qwen3.5 notebook 的 RMSNorm 参数初始化为 0,实际缩放是
全局 attention 的 W_query 输出 2*d,再一分为二得到 query 和 gate。gate 的形状还原为
拆分必须在每头内部进行。若先把整个
partial_rotary_factor 让只有前
20.5 线性层:卷积记忆加矩阵记忆
TransformerBlock 按 layer_types 选择 GroupedQueryAttention 或 Qwen3_5GatedDeltaNet。_Qwen3_5ConfigAdapter 仅把教学字典里的名称映射到 helper 期望的字段:隐藏宽度、key/value 头数、各自头宽、卷积核宽、激活、eps 和 dtype。它没有调用 Transformers 模型,也没有下载内容。
helper qwen3_5_transformers.py 标明来自 Hugging Face Transformers 的 Apache 代码,并将可选快速 kernel 置为 None,回退到 PyTorch。它先将输入投影为 Q/K/V 合并通道,再做逐通道因果一维卷积和 SiLU;卷积宽度
更新门为
由于 Qwen3_5RMSNormGated 对读出归一化并乘 SiLU 门,再输出投影。
20.6 chunk 与 recurrent helper 如何相互校验
torch_recurrent_gated_delta_rule 与第 11 章逐 token 公式对应,输入先转 float32,Q/K 可作 L2 norm,Q 再乘
torch_chunk_gated_delta_rule 为分块版本:把长度补齐到 chunk_size 的倍数,构造块内下三角的衰减关系,解出误差更新对前序 token 的依赖,再将旧状态贡献与块内贡献合并,最后更新块末状态。g.cumsum 使连续遗忘乘积转为累加后求指数。padding 的 Q/K/V/beta 为零、g 为零,对应无写入且衰减为 1,最后再切回原长度。不能把补齐 token 当作真实 token 计入 loss。
本书实际导入了已检查无下载副作用的 helper,对长 7、chunk_size=4、两个头、key 维 3/value 维 4 的张量比较两个入口。输出和最终状态最大误差均为 python examples/architectures/source_smoke.py,准确日志在 qa/architectures/source_smoke.json。
torch_causal_conv1d_update 则拼旧卷积状态和新输入、更新缓存尾部、按通道卷积并只取新序列的输出。apply_mask_to_padding_states 对支持的多 batch 场景遮掉 padding 输入;它有具体条件分支,不能据此宣称支持任意 padding 布局。logger 只去重打印快速 kernel 不可用提示,两个占位配置类型仅服务注解,不实现完整 Transformers API。
20.7 混合缓存的一个重要限制
Qwen3_5LinearAttentionCache 保存每层 conv_states、recurrent_states 和 has_previous_state;外部 KVCache 同时持有普通 KV 列表。模型级 current_pos 管理全局层的位置。清理请求时三者都必须复位。
helper 的增量分支要求已有状态且 seq_len == 1 且提供 cache_position。否则它走 chunk 分支,并以 initial_state=None 开始。由此可知,这份教学实现的安全路径是“整段 prompt 预填充,然后逐 token 解码”;不能未验证就宣称支持任意多 token 的追加 chunk,因为那条路径可能重置递推记忆。把第 10 章 SWA 的 chunk 测试原样推广到这里会漏掉这个区别。本书随后用两层混合小模型实际验证:整段预填充后逐 token 追加,与完整前向最大误差为 qa/architectures/cache_checks.json,不能计为支持任意chunk的通过结果。
20.8 加载、真实结果与练习
两组 notebook 的加载器均显式映射 embeddings、投影、norm、FFN 和 output head;Qwen3.5 还映射卷积、A_log/dt_bias、四份输入投影和 gated norm。Hub 下载、safetensors 合并、tokenizer 文件、chat template、停止 ID、流式生成构成后半条调用链。本书没有执行这些外部路径,也没有获取权重。
真实缩小源码检查中,Qwen3 dense/MoE 都产生
补充题与答案。 ① Qwen3 的头宽为什么不能总由 D/H 推出?因为配置允许注意力内部宽度与残差宽度不同。② Qwen3.5 的全局门和 delta 的 beta 是同一个量吗?前者调节读出,后者调节写入。③ 只清普通 KV 列表能隔离请求吗?不能,卷积和矩阵状态也会泄漏历史。④ 为什么 chunk/recurrent 测试不用
20.9 上下文拒绝、参考调试器与聊天界面
tests/test_qwen3_kvcache_nb.py 的两个边界测试特别重要:长度超过 context 时应抛出清楚的 ValueError;失败的追加调用不能先把 current_pos 或 KV cache 改坏。源码先算 pos_end、校验、再更新状态。context_model_setup 对密集与 MoE notebook 参数化,dummy_cfg_* 提供小模型;普通形状与可选 Transformers 同权重对照是另外两种测试。不要把文件名含 kvcache 当成每条测试都验证了增量等价。
本书 cache_checks.py 实际以 [0:2],[2:5],[5:6] 分块,得到 Qwen3/MoE 最大误差分别 qa/architectures/cache_checks.json。
Qwen3.5 的 tests/test_qwen3_5_nb.py 通过 _import_qwen3_5_classes 检查参考库支持,避免拿旧 Transformers 的不存在类作对照。qwen3_5_layer_debugger.py 的 tiny_debug_config 与 _hf_config_from_dict 对齐两边配置,build_qwen3_5_pair 用相同权重创建成对模型;_attach_debug_hooks 记录 embedding、层及相关模块输出,hook 内 _record 对 tuple 取张量、detach、转float32和CPU。layerwise_differences 对齐名字并计算差异,_layer_sort_key 保持数值层序,format_report 格式化报告。可选 hf_checkpoint 会触发预训练路径,本书不运行;无参考库也没有伪称这些对照通过。
Qwen3 目录还包含两个 Chainlit 界面脚本。单轮版的 get_qwen_config/build_repo_and_local/get_device/get_model_and_tokenizer 负责选配置、选Hub目录、选设备和载入模型;异步 main 编码用户输入、裁上下文、流式输出。多轮版添加 on_start 的会话历史、build_prompt_from_history 的角色边界、assistant header,并关闭 tokenizer 自带模板以免重复包裹;回答完将 assistant 内容写回会话。结束判定兼顾模型可能输出的两种终止ID。历史文本被裁剪为token窗口,并不保证保留完整回合边界,生产使用应另定裁剪策略。
这两个界面在模块顶层调用模型下载/初始化,不能为了“只看一个函数”直接 import。这里仅静态审阅,没有启动服务、下载权重或发送任何外部消息。public/logo_*.webp 是界面资产,不复用到本书;requirements 文件表达界面依赖,不代表当前环境已安装。
参考资料
- 固定源码
ch05/11_qwen3、ch05/16_qwen3.5,包括 helper 原始版权说明。 - Qwen3 技术报告:https://arxiv.org/abs/2505.09388。
- Qwen3.5 官方模型资料:https://huggingface.co/Qwen/Qwen3.5-0.8B。
- Gated Delta Networks:https://arxiv.org/abs/2412.06464。
- 未验证:完整 checkpoint 输出、量化、快速 kernel、原规模训练、任意 chunk 增量解码。