主题
第 23 章 扩展分词器:新 ID 还需要新的模型行
给分词器加一个特殊 token,程序可能立刻能把它编码成一个整数。但模型看到这个整数以后,第一步就会去 embedding 表查相应的行。如果表没有扩大,结果是越界;如果表扩大了却没训练新行,结果只是“可以计算”,还谈不上“理解了新符号”。本章把分词器、输入表、输出表和优化器连起来处理。
固定来源是 extend-tiktoken.ipynb。源码演示 GPT-2 词表增加两个特殊项,本书不下载 GPT-2 权重,改用本地小张量检验兼容性。
23.1 特殊 token 与普通 BPE 合并项不同
普通 BPE 根据 regex 切分和 merge rank 反复合并字节片段;特殊 token 是识别到特定字符串后,按明确规则直接返回指定 ID。给普通 mergeable ranks 随便加一个字符串,并不保证编码器能通过现有合并路径得到它,还可能改变其他文本的切分。
上游单元 3—6 先展示一个新字符串被切成多个子词;单元 9 分配新 ID,单元 11 创建新的 tiktoken.Encoding,复用 _pat_str 与 _mergeable_ranks,并合并 _special_tokens。这些下划线属性是具体版本的内部接口,发布工具时应固定 tiktoken 版本并测试;官方可扩展接口说明见 tiktoken 项目。
若原 ID 为连续的
allowed_special 是明确的解释许可。未允许的特殊串可以触发报错,或在显式选择普通文本处理时按字节/BPE 编码。不能对不可信用户文本默认把所有特殊字符串解释为系统边界;分词允许机制只管理表示层,本身不提供角色权限隔离。
23.2 输入 embedding 为什么必须增加行
输入表
源码单元 37 新建 Embedding 并复制旧行。稳健实践还应显式保留原 device、dtype、padding_idx 和 requires_grad,而不是默认建一个 CPU float32 模块。不要在 autograd 外随意使用 .data 改写;本书验证用 torch.no_grad() 与 copy_。如果模型曾被包装、编译或建立优化器,替换 Parameter 还会影响外部引用,见 23.5。
新行可随机初始化,也可由原先子词 embedding 的统计组合提供起点,但后一种方法不是保证语义正确的公式。新的 token 改变了序列分割,必须用包含该符号的合适数据继续训练,并评估旧能力是否被破坏。
23.3 输出头也必须扩展,但旧概率不会保持不变
输出头矩阵
令
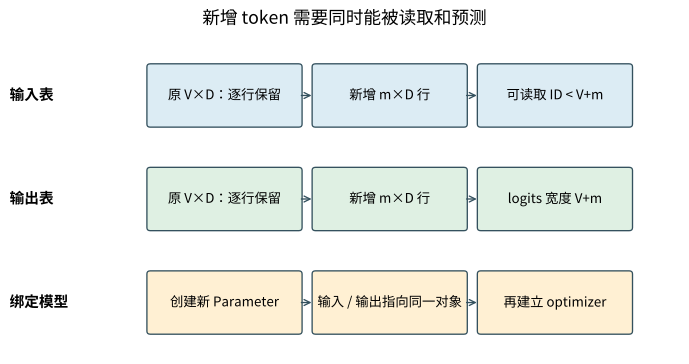
上游单元 43 用 Linear 新建输出层,但没有显式继承旧层的 bias=False。若旧 GPT 输出头无 bias,新层默认带随机 bias,即使旧 weight 复制正确,旧 logits 仍会改变。本书示例显式以 bias=False 创建。若原层有 bias,就复制旧 bias 并明确初始化新部分,不要引入一个此前不存在的自由度。
23.4 Weight tying 必须共享对象,不只是值相同
绑定模型令 out_head.weight 绑定为同一个对象。上游单元 50 演示了这种绑定。若仅执行 out_head.weight.copy_(tok_emb.weight),两份 Parameter 初值相同,但下一步梯度和更新就可能分离。
绑定以后要核对输出层元数据与保存/加载策略。直接替换 weight 虽可能让矩阵乘法按新 shape 工作,模块的 out_features 字段未必自动同步;稳健做法是重新创建匹配的新 Linear 再绑定。若模型设计原来不绑定,不能因为扩词表方便就擅自绑定,那会把两个独立矩阵限制为同一个,改变旧模型。
23.5 优化器、数据与 checkpoint 都要一起迁移
优化器初始化时保存 Parameter 对象引用。随后用新模块替换 embedding,旧 optimizer 仍可能更新旧对象,新行完全不训练。最简单的教学流程是先扩词表、建立绑定,再创建 optimizer。要续训并保留动量时,必须为新参数迁移旧行对应的状态,并初始化新行的状态;本章没有提供泛化到所有优化器的自动迁移器。
旧 token 化数据若只含旧 ID,仍可读取,但含新字符串的样本会采用旧切分,不能体现新 token 的训练目标。重新编码的数据、扩展 tokenizer 配置、模型 vocab_size、矩阵 shape 和特殊 ID 映射应成套保存。切换回旧 tokenizer 可能仍能产生旧 ID,却无法正确解码新增预测 ID。不同词表的 checkpoint 仅凭文件名类似不能混用。
上下文长度也有细微变化:一个原本占五个 token 的串变成一个,后面 token 的位置会前移。即使旧行保持不变,整段输入的隐藏状态也不会保持,因为 token 数和位置关系已经改变。“兼容旧 ID”不等于“含新字符串的文本输出不变”。
23.6 真实小实验、源单元与练习
architecture_checks.py 的 vocabulary() 从 qa/architectures/algebra_checks.json。此实验不用网络,不依赖预训练分词词表。
源单元 14—16 验证新增特殊 ID 编码和逐项解码;21—22 是 GPT-2 权重获取与配置初始化,本书未执行;25—32 对比旧/新 ID 并展示越界;35—38 扩输入表;41—47 扩输出头并运行;49—51 讨论绑定。这些单元各自解决不同接口,不应只用“扩展 tokenizer”一句概括。
补充题。 ① 新输入 ID 最大为 100,embedding 有 100 行是否足够?② 只复制输出 weight 为何还可能改变旧 logits?③ 旧 logits 保持时,旧概率为什么变了?④ 扩展后 loss.backward 成功,新 embedding 却不更新,应先查什么?
答案。 ① 不够,100 行合法编号为 0—99。② 新增了未复制的 bias、dtype/device 或前向协议改变都可能造成差异。③ 新输出项也进入 softmax 分母。④ 查 optimizer 参数引用是否包含替换后的 Parameter,再查 requires_grad 和数据中是否真的出现新 ID。
23.7 不下载词表的真实 tiktoken 检查
cache_checks.py 还用 tiktoken 0.9.0 在本地构造256项单字节词表,正则按单字符切分,再加入特殊项 <|new|>,ID为256。encode("a<|new|>b", allowed_special={"<|new|>"}) 实测得到 [97,256,98],decode还原原字符串;不提供特殊许可时确实抛出ValueError。这个例子验证Encoding扩展和特殊项许可,不冒充GPT-2的真实merge ranks或语言效果。它不调用 get_encoding,所以不会为缺失的编码表触发网络下载。
参考资料与未运行边界
- 固定源码
ch05/09_extending-tokenizers/extend-tiktoken.ipynb。 - tiktoken 官方源码与扩展说明:https://github.com/openai/tiktoken。
- 未运行:GPT-2 下载、新 token 语义训练、真实大词表重新 token 化与 optimizer 状态迁移。