主题
第 10 章 局部与稀疏注意力:SWA 和 DSA
第 09 章讨论如何用更少的空间保存历史。本章换一个问题:一次 query 是否需要读取全部历史位置?SWA 按距离保留一个窗口,DSA 则由可训练的索引器打分,选择历史位置。这里的教学实现展示选择过程,并不意味着索引器已经学会了有效的检索策略。
读这两类实现时,要同时检查输出和执行过程:输出有没有使用被禁止的位置,程序又有没有真的少做计算?在稠密矩阵上加 mask,可以限制哪些位置参与输出,却不一定减少已经完成的计算。
10.1 SWA 的窗口到底包含谁
零基位置
例如 MultiHeadAttentionWithSWA 先形成差值 (diff < 0) | (diff >= W) 标记禁止位置。第一项挡住未来位置,第二项挡住距离过远的历史。少了第二项,就只有因果注意力,没有滑动窗口;若写成 diff > W,又会多放进一个 token。见 固定 SWA 源码。
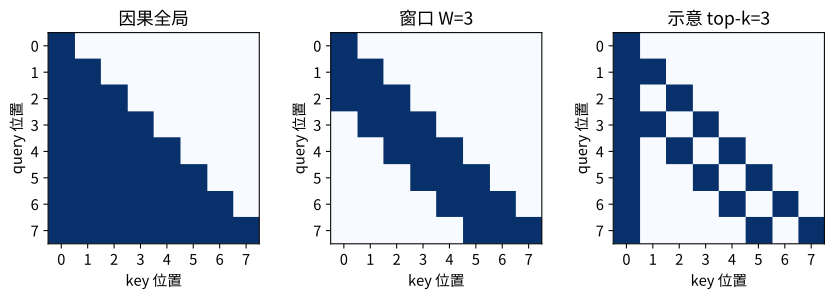
一个局部层读不到窗口以外的位置,但它读到的隐藏状态可能已经汇入更早的信息。这样叠加多层,信息仍能逐步传播。若每层窗口为
10.2 持久缓存可以只留 W,当前计算却未必只用 W
逐 token 解码时只需保留最后
源码先保存 old_cache 与 old_len,拼出 combined_k/v。注意力所需部分保留最多 W + num_tokens - 1;下一步的持久 cache 只留最后 W。前一个切片服务当前块中所有 query,后一个切片服务后续解码,不能互换。
裁剪还带来一个位置问题。丢弃开头若干项以后,用 k_start_pos_abs = ptr_current_pos - old_len + dropped 找回 key 的绝对起点。query 从 ptr_current_pos 开始。缓存即使只剩三个槽,也仍保存着原序列中的位置关系,不会把槽里的 token 误当成位置 0、1、2。
若有
memory_estimator_swa.py 解析比率、分配整数量的局部/全局层,再求和;不能把 sliding_window_stride 决定哪些层使用局部注意力,所以还要核对模型实际分配的层数是否与估算一致。绘图脚本只是在不同长度上重复这项估算。训练时,教学实现仍构造
10.3 DSA:先索引,再做注意力
固定窗口按位置筛选,窗口外的 token 即使与当前 query 有关,也无法被直接选中。DSA 尝试让选择依赖内容:索引器先为候选历史生成相关性分数,再选择 top-
设索引头数 W_q_index 输出 W_k_index 输出共享的 W_weights 输出
topk(...).indices。DeepSeek-V3.2 官方报告 是完整系统的来源,本文只对已列教学实现作代码级解释。
索引器必须在 top-topk 为凑满固定输出宽度可能返回分数为负无穷的未来索引。最终只保留“被选中且不在未来”的位置,才能避免这些补足名额的索引参与 softmax。
主注意力根据被选位置构造 bool mask,把其余 logit 置为负无穷;随后缩放分数,执行 softmax,再对 V 加权。这里还需要检查是否出现整行都被挡住的情况。若所有分数都是负无穷,softmax 的归一化过程中会出现负无穷减负无穷,得到 NaN。把负无穷换成有限最小值,无法修复这个逻辑错误:整行数值相同时,softmax 可能给出均匀分布,反而让不允许的位置参与输出。有效 query 至少应有一个合法 key。
10.4 稀疏选择不等于稀疏执行,也不等于自动学会选择
教学 MultiHeadAttentionWithDSA 首先计算完整的 cache_x,让索引器重投影历史输入。相较普通 MHA,这里还额外保存了历史隐藏状态。因此,这个文件虽然实现了稀疏选择,却没有据此减少 KV 存储。原理上稀疏 kernel 可只对选中键执行主注意力点积,约为
即使选点逻辑正确,还有一个问题:索引器从哪里获得学习信号?topk 的索引是离散的,而该实现只把索引用于布尔 mask,主任务 loss 无法沿索引回传到索引器分数。如果没有额外的可微训练目标,仅把随机索引器接进 GPT、继续优化语言模型 loss,就不会沿这条路径学到预期的检索策略。因此,理解部署报告中的收益时,还要看索引器如何训练、稀疏计算如何执行;上游这个文件提供的是可以逐步检查的选点演示。
10.5 配套脚本与验证路径
SWA 的 TransformerBlock 根据层编号选择局部或全局模块,残差、LayerNorm、GELU 前馈没有改变。模型级位置 embedding、reset_kv_cache、缓存生成以及参数 CLI 与第 09 章同一主干。DSA 多出三个索引参数:头数、头宽和 top-
tests.py 和 test_dsa.py 的核心检查包括完整输入与缓存预填充的一致性、跨 chunk 的窗口边界、选择不会越过因果边界、top-
本书完整程序 examples/architectures/architecture_checks.py 中的 masks_and_sparse() 用 7 个 token、宽度 3、分块 [0:2],[2:5],[5:7] 验证 SWA。原稿记录,完整与分块输出误差为 0;修改未来 value 后,过去输出误差为 0。DSA 的稠密 mask 与逐 query 实际 gather 的结果最大误差为 qa/architectures/algebra_checks.json。当前提供的文件包含程序,却缺少这份历史日志,所以上述精确误差只能作为原稿记录保留,不能当作已核验的运行结果。这里也没有速度测试。
10.6 补充练习与答案
题目。 ① 宽度 4、query 位置 9,可见哪些位置?② 分块长度 5 时,为什么当前注意力可能要用 8 个历史/当前位置?③ 如果先 top-
答案。 ① 6、7、8、9。②
进一步检查真实上游 SWA、DSA 类的程序是 source_attention_checks.py。原稿报告,完整前向与三块缓存计算的最大误差均为 0;对 DSA 主输出平方和反传后,所有 indexer 参数的 grad 都为 None,与 10.4 所述训练边界一致。对应日志为 qa/architectures/source_attention_checks.json,当前文件中同样缺少这份历史记录。检查程序确实包含这些断言,但仅阅读源码还不能确认历史运行的精确结果。
参考资料与未验证边界
- 固定源码
ch04/06_swa、ch04/09_dsa,模型、估算、绘图和测试均纳入覆盖台账。 - Longformer:https://arxiv.org/abs/2004.05150。
- Gemma 3:https://arxiv.org/abs/2503.19786。
- DeepSeek-V3.2 官方报告:上文链接。
- 未验证:长上下文语言质量、稀疏 CUDA kernel、索引器训练、报告中的部署成本。