主题
第 12 章 MoE:路由、专家与负载
一个前馈层可以包含很多参数,但处理每个 token 时,是否都要用上全部参数?混合专家模型(Mixture of Experts,MoE)的做法是把一个前馈模块换成多个专家,再由路由器为当前 token 选择少数专家。这样通常能增加总参数量,同时让每个 token 只使用其中一部分。代价也要一起算:专家权重需要存储,token 需要分派,不同专家还可能忙闲不均。
本章解释固定提交 ch04/07_moe 的代码。这里的注意力仍是带 KV cache 的普通 MHA,MoE 换掉的是前馈模块。
12.1 路由器决定“谁来计算”,专家决定“计算什么”
设输入为
这与先对所有专家 softmax 再取 top-topk_scores.softmax(-1)。
每个专家使用门控前馈。令中间宽度为
其中 fc1/fc2/fc3 的 ModuleList,注册为模型的子模块,优化器才能通过模型参数列表找到它们。如果只放进普通 Python list,又没有另行注册,前向计算可能照常运行,但这些参数会漏出常规的训练、存盘和设备迁移流程。
12.2 为什么先展平,再按专家收集 token
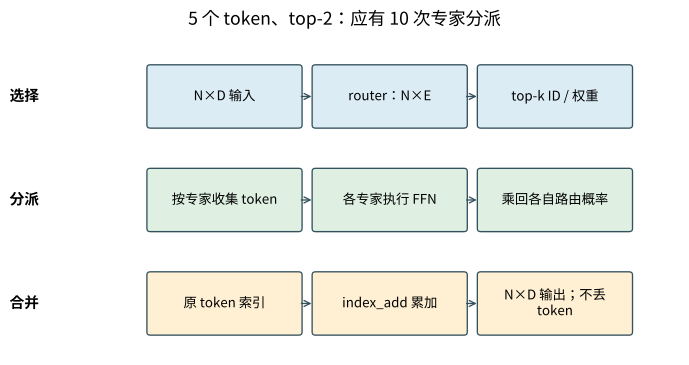
如果逐个 token 调用选中的专家,就会产生大量 Python 循环和零碎的小矩阵乘法。按专家把输入收集到一起,可以让每个专家一次处理一批 token。源码把 unique_experts。
对专家 topk_indices_flat == e 得到 any,就能判断哪些 token 被交给当前专家;nonzero 得到 selected_idx,index_select 收集专家输入。计算结束后,还要为每个 token 找回当前专家在 top-gather 取出对应概率。同一个专家在不同 token 的列表中可能排在不同位置;如果一律取第一列概率,就会给部分结果乘上错误的权重。
最后 out_flat.index_add_(0, selected_idx, expert_out * selected_probs[:,None]) 将结果加回原 token。这里必须累加,因为一个 token 会收到 argmax 找 slot,这依赖 topk 给每个 token 返回互不重复的专家编号。
MoE 不改变 token 的顺序或数量。输入
12.3 总参数、激活参数与内存是三笔账
忽略 bias,MoE 层总参数约
减少激活参数,并不保证运行时间也按同样比例下降。许多小专家的矩阵乘法可能无法充分利用硬件;同一 batch 的不同 token 合起来,可能用到许多甚至全部专家;把专家分到多台设备上,还会引入通信。源码通过 Python 循环、.item()、index_select 和 index_add_ 清楚展示分派,但没有融合 kernel 或跨设备调度。
上游 memory_estimator_moe.py 与 plot_memory_estimates_moe.py 分别报告和绘制总参数量、每 token 活跃参数量。计算时,get_num_param_matrices 区分两矩阵 GELU 与三矩阵 SwiGLU,calc_router_params 则计入路由器的
estimate_params_and_hidden 在启用 match_dense 时,先从密集层的参数预算中扣除 router,再除以专家数和每单位宽度所需的参数量,最后四舍五入,得到每位专家的中间宽度。如果 router 已用尽密集层预算,程序就会报错。这个选项匹配的是近似总参数量,并没有匹配每 token 的激活参数量。
比较结果前,要先核对 FFN 的中间宽度,以及使用的是两矩阵 GELU FFN 还是三矩阵门控 FFN。如果专家数和中间宽度同时改变,就不能把所有差异都归于路由。gpt_with_kv_ffn.py 提供密集对照,gpt_with_kv_moe.py 根据 num_experts > 0 选择分支。计时列表和设备内存统计只是测量辅助,不属于 MoE 的数学定义。
12.4 负载集中为什么会成为问题
假设 100 个 token 都选同一位专家,其他专家闲置;分派总数虽然没有错,计算负载却集中在同一处。若引入容量上限
Switch Transformer 是理解 top-1 路由、容量及辅助均衡目标的原始参考。一个常见辅助目标形式是
硬 top-
12.5 接回主干、验证与练习
MultiHeadAttention 的 query/key/value 投影、绝对位置因果 mask 与 KV 缓存没有因 MoE 改变。LayerNorm/GELU/FeedForward 提供密集基线;TransformerBlock 在第二个残差分支选择密集或专家前馈;GPTModel、缓存重置和生成入口延续第 09 章的调用协议。README 的大配置与 GPU 时间是来源示例,本书未复跑。
完整程序 examples/architectures/architecture_checks.py 的 experts() 用 5 个 token、3 位专家、top-2,对比按专家聚集与逐 token 求和。为隔离分派逻辑,专家缩成线性映射,不能视为完整 SwiGLU 模型复现。原稿报告输出误差为 0,10 个分派全部计入;人为设每位专家容量为 1 时,出现 7 个超额分派。Python 3.12.14、torch 2.6.0+cpu、seed 1949、float64、单线程,原稿指向的准确日志为 qa/architectures/algebra_checks.json。当前交付目录未包含这份日志,因此这些数值仍按历史记录保留,本轮未重新执行或核验输出。
补充练习。 ① top-2 输出合并时为什么要 index_add_?② 专家总数翻倍、每 token 仍选两位,哪些成本增加,哪些近似不变?③
答案。 ① 两份贡献必须相加,覆盖会漏掉一份。② 总专家参数及其存储增加,每 token 的专家算术量近似不变,router 输出与调度成本可能增加。③ 选中集合仅一个元素,softmax 值恒为 1;离散索引本身无常规梯度。④ 数学上空 batch 没有贡献,工程上会增加无用调度,某些模块还可能不支持空输入;源码因此跳过。
原稿还记录了另一项检查:以 source_attention_checks.py 调用上游真正的三矩阵 MoE 专家,设为 top-1,对输出平方和反向传播,报告 router 权重最大梯度为 0。测试代码确实包含这项检查,但当前交付目录没有对应的输出日志,本轮也没有重新执行,因而不能把这个历史数值当作新测量结果。它针对的是 12.4 所述的训练失败条件,不表示 top-2 等配置的梯度也必为零。
参考资料
- 固定源码
ch04/07_moe全目录。 - Fedus 等,Switch Transformers:https://arxiv.org/abs/2101.03961。
- 门控前馈的原始研究:https://arxiv.org/abs/2002.05202。
- 本章未运行专家并行、容量溢出训练、负载均衡训练或吞吐基准。