主题
第 13 章 预训练目标、交叉熵与验证集
模型输出 [B,T,V] 的 logits 后,还需要一个标量来衡量预测有多差,优化器才能据此调整参数。训练循环只有几步,但每一步都依赖几个容易忽略的约定:哪个位置预测哪个 token,损失平均了哪些项,验证数据有没有泄漏,以及损失曲线下降能说明什么。
本章对应上游 ch05 主 notebook 的训练部分、gpt_train.py 及相关练习。生成策略放在第 14 章,保存恢复与官方权重映射放在第 15 章,这样可以分别看清训练、生成和权重管理各自负责什么。固定训练脚本
13.1 交叉熵取的是目标 ID 对应的概率
设位置
目标张量形状为 [B,T],每项是一个整数 ID,不需要先转 one-hot。上游先显式索引目标概率、取 log、求平均,再与 cross_entropy 比较。逐步计算能帮助理解 API;实际训练时则应直接把 logits 交给损失函数,避免先算出的概率下溢为零,再取 log。
对单个位置,可以改写为
设
13.2 flatten 不应该打乱位置与标签配对
logits.flatten(0,1) 把 [B,T,V] 改成 [BT,V],targets.flatten() 把 [B,T] 改成 [BT]。二者都先排完一个样本内的所有位置,再排下一个样本,所以第
cross_entropy 需要未经 softmax 的分数。配套历史结果记录了一个反例:对 [4,0,-2]、真实类别 0,正确 loss 为 0.0205811;先 softmax 再交给 cross_entropy 得到 0.5645241。后者不会报错,因为概率也是浮点数,但 API 又把它当 logits 做了一次归一化。
均匀分布给每个 token 概率
13.3 perplexity 依赖分词与计量单位
困惑度定义为
不同分词器把同一文字切成不同数量的 token,平均每 token 损失所对应的文本量也就不同。因此,不能直接用两种分词器下的 perplexity 判断谁的语言能力更强。即使分词器相同,数据域、上下文长度、文档边界和 loss mask 不同,也会改变指标。
13.4 验证集要在造重叠窗口之前分开
上游把短文按字符位置切成前 90% 训练、后 10% 验证,再各自分词、建窗口。先分开文本再建窗口,可以避免重叠内容跨入训练集和验证集。但同一作品的前后段仍高度相关,这样得到的验证结果不能代表模型在广泛领域的泛化表现。对于多文档语料,更稳妥的是以文档、来源或时间等有意义单位划分,并去除跨划分重复。
字符比例不等于 token 比例。用 total_tokens*ratio 提醒数据是否够长,只能做粗略检查。更可靠的做法是分别编码两段,确认各自至少有 context_length+1 个 token,再检查 drop_last 后是否还留有完整批次。训练 loader 打乱并丢尾,验证 loader 不打乱且保留尾部,这些设置会影响实际参与统计的 token 数。
13.5 loader 平均要明确分母
上游 calc_loss_batch 返回一个批次的 token 平均损失;calc_loss_loader 再对若干批次的平均损失求平均。各批有效 token 数相同时,这才等于所有 token 的整体平均。如果最后一批较小,或者未来引入 padding/loss mask,使各批有效 token 数不同,就不能给每个批次相同的权重。
假设第一批有三个 token,损失都是 1;第二批只有一个 token,损失为 4。正确 token 平均是
上游空 loader 返回 NaN,提醒没有可评估数据;若显式 num_batches=0,还需避免零分母。限制 eval_iter 可以节省时间,但只评估前几个 batch 的结果是局部估计,不能写成完整验证集指标。训练 loader 开启 shuffle 后,每次迭代的顺序可能不同,取前几个 batch 评价时,实际选中的样本也会随之变化。
13.6 训练、评价、采样三段的模式切换
train_model_simple 每个批次先清梯度、前向算 loss、反向、优化器更新,然后增加 tokens_seen 和 global_step。tokens_seen += input_batch.numel() 计的是累计处理过的 token 数。重叠窗口和多轮训练会重复计数,因此它不等于独立语料的大小。
评价函数切到 eval,并在 no-grad 下计算训练与验证损失,然后恢复 train。样例生成也暂时切 eval,结束后恢复 train。这符合训练循环的需要。如果要把这些函数用于其他场景,就应保存并恢复调用前的模式。本书生成函数采用了后一种方式。
读训练曲线时,还要弄清每个损失值何时计算、采用什么模式:是在参数更新前还是更新后,直接记录训练前向的结果,还是切到 eval 模式重测。dropout 开启时,一个训练批次的即时 loss 与 eval 模式下相同样本的 loss 不必相等。比较曲线时要统一定义。
13.7 AdamW 更新与短实验的目的
AdamW 保存梯度一阶、二阶移动平均,并对参数做解耦权重衰减。它需要额外状态,因此内存预算不同于 SGD。学习率和 weight_decay 都改变训练轨迹,固定 seed 不能抵消这些设置差异。
本书的历史小实验没有训练 124M 模型,而是使用 0,1,...,7 上造长度 8、stride 8 的窗口,AdamW 学习率 0.015、weight_decay 0.01,梯度范数上限 1,更新 60 次。已保存的历史结果中,第 0、10、20、30、40、50、60 步计算的损失依次约为 2.315901、0.244195、0.032200、0.007208、0.003374、0.002243、0.001781。本轮已核对记录与脚本,未重新运行训练。
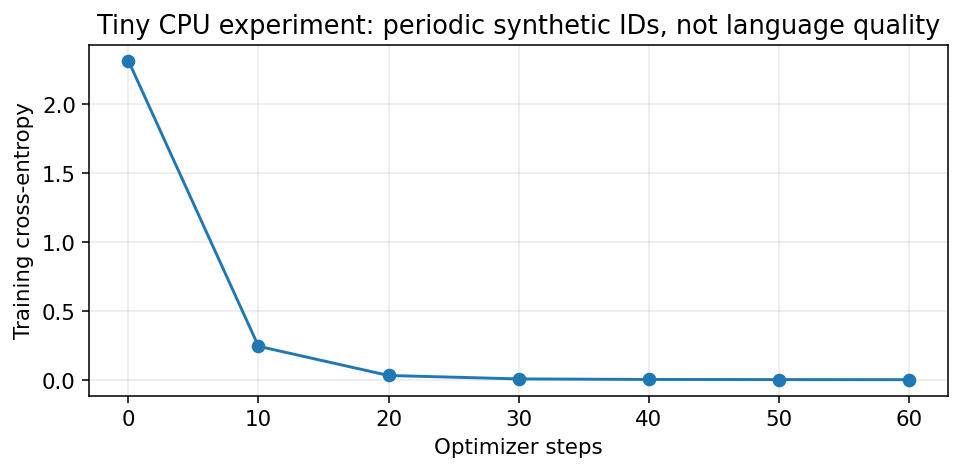
这个任务刻意简单:每个 ID 的后继几乎确定,所以 loss 应快速下降。损失下降能帮助检查梯度、参数更新和标签对齐是否配合正常,以及模型能否拟合这个任务。它不能验证自然语言质量、事实性或泛化;把同一周期数据切成两半,也不足以得到独立的语言验证集。
13.8 如何读上游训练脚本和测试
text_to_token_ids 增加批次维,token_ids_to_text 去掉单条批次维并解码;它们默认面向 batch size 1 的显示。主 notebook 允许结束符号,集中训练脚本的简单包装使用默认编码策略,因此,文本中出现特殊 token 的字面写法时,这两个包装函数可能有不同表现。
generate_and_print_sample 每轮生成短文本,并把换行替换为空格,仅影响终端显示,不改变模型训练数据。plot_losses 用 epoch 和 tokens_seen 两个横轴展示训练进度;若评价点间隔不均匀,用 linspace 映射 epoch 只是近似,最好记录真实更新位置。
main 先尝试读取本地短文,缺少文件时再下载,然后建立模型和 loader,启动训练循环。直接执行该文件时,末尾还会保存权重及损失图。本书不运行其默认大配置;同目录 tests.py 用宽度32、2层、上下文12的缩小模型检查三条日志列表各有39项;另用 HEAD 检查两处镜像、两个尺寸的文件长度。前者依赖固定数据和评价频率,后者只验证可访问性和长度,均不等于权重内容校验。本书未调用这些网络测试;自己的缩小训练脚本则直接检查损失与保存恢复。本轮只核对源码和已有结果,没有运行上述测试。
13.9 练习与答案
补充题一:词表 16 项,完全均匀预测的 loss 和 perplexity 是多少?答案为
补充题二:把所有 logits 加 100,交叉熵是否改变?提示:把常数代入 log-sum-exp。答案:精确算术下不变,分子分母的公共因子抵消;稳定实现应在正常有限范围内保持这一性质。
补充题三:训练 loss 继续降,独立验证 loss 开始升,应先检查什么?答案包括数据泄漏、评价模式与分母、训练集和验证集的分布,以及是否过拟合。先排除评价口径和数据问题,再判断训练本身;不能只凭一条曲线决定扩大模型。上游续训练习在第 15 章讨论恢复状态,不应把重新加载权重当作完整续训。
执行 python examples/core_training/run_checks.py 可重跑训练闭环,执行 python examples/core_training/loss_sampling_checks.py qa/core_training/loss_sampling.json 可检查交叉熵梯度与平均分母反例。
参考与覆盖
- ch05 主 notebook:目标概率、负对数平均、flatten、perplexity、划分、loader、训练和曲线。
- gpt_train.py:转换包装、批损失、loader 评价、模式切换、采样显示和 main。
- 同目录生成、checkpoint 与预训练参数单元分别在第 14—15 章解释,避免遗漏与重复计算覆盖。