主题
第 08 章 KV cache:先证明等价,再讨论加速
上一章提到,生成时如果只计算新增位置,就能省下重复工作。具体能省哪一部分?假设模型已经读过六个 token,现在追加第七个。没有缓存的生成循环通常会把整个前缀再送进模型,于是前六个位置在每一层都要重算。
但因果模型中的前六个位置看不到第七个。只要计算条件不变,追加一个未来 token,就不会改变它们已经算好的表示。KV cache 利用这个性质,保存后续注意力还会用到的键和值,让下一步可以直接复用。
复用成立的条件要先说清楚:权重不变、位置编号一致、可见上下文不变,并且关闭训练随机性。普通训练每次更新权重后,旧 K/V 就不再对应当前模型,不能拿到下一批继续使用。本章先在这些条件下说明等价性,再讨论实现和加速。上游 KV cache 目录
8.1 为什么可以按层复用
先从第一层看起。一个旧位置的输入由该 token 和它的位置决定,追加 token 不会改变这份输入。因果注意力又只读取该位置及其之前的内容,因此旧位置的第一层输出也保持不变。
这个推理可以逐层重复:假设第
生成新位置时,需要它自己的查询
从公式也能看出为什么名字叫 KV cache:新输出用的是新查询与已有键和值,旧查询不再参与这一步,所以通常只缓存 K 和 V。
不过,每层的 K/V 都是由该层输入算出来的,不能拿第一层的缓存给后面所有层使用。除非架构专门设计了共享机制,否则各层都要维护自己的缓存。
8.2 prefill 与 decode 的形状不同
生成通常分成两段。prefill 先一次处理提示词的 [B,H,P,d]。接着进入逐 token 的 decode:第一次追加一个位置时,Q 是 [B,H,1,d],K/V 则拼接成 [B,H,P+1,d]。分数矩阵因此变成 [B,H,1,P+1],只需计算新增查询对应的一行。
也可以一次追加多个 token。若新块长度为 [B,H,C_n,d],键值长度则是
这时不能直接给 [C_n,P+C_n] 套上从左上角开始的普通三角 mask。新查询的位置已经向后偏移了 P,忽略这个偏移,就会把本该可见的大部分历史上下文也遮掉。
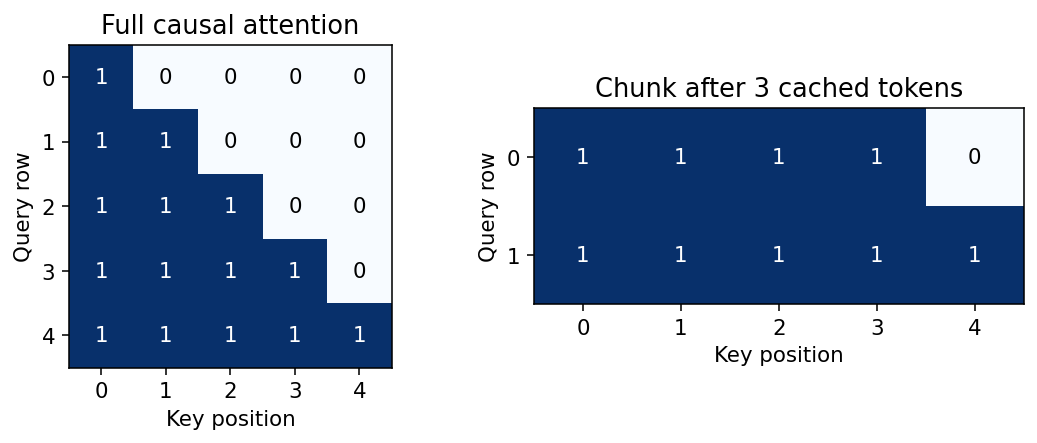
图右已有三个 token,再新增两行查询,第一行应能看见四列,第二行应能看见五列。为这个偏移单独写断言,可以直接检查 mask 有没有遮错位置。
8.3 上游朴素版怎样保存状态
有了形状和 mask 的约束,再看上游的朴素实现。gpt_with_kv_cache.py 在注意力层把 cache_k/cache_v 注册为非持久 buffer,初始值为 None。启用缓存时,每次前向只投影新输入;第一次直接保存,后续沿 token 轴用 cat 接上去。缓存保存的是 [B,T,H,d] 布局,计算注意力前再转置成 [B,H,T,d]。
这里还需要跟踪位置。每层的 ptr_current_pos 用来选取原三角 mask 中对应的行,模型级的 current_pos 用来选位置 embedding。前者决定新查询能看见哪些位置,后者决定输入使用哪一份位置特征。两者必须一起向前推进,否则缓存路径就会偏离完整前向。
为了把缓存开关传到注意力层,TransformerBlock.forward 增加了 use_cache 参数。模型也改为显式遍历 block,不能再沿用只传 x 的 Sequential 调用。
这些状态还要有明确的清理时机。reset_kv_cache 会遍历各层,清除 K/V 和指针,再清空模型位置计数。新请求开始前必须调用它;如果同一个模型对象服务两个请求,就需要隔离各自的状态,避免把一个请求的历史带进另一个。
8.4 本书采用显式输入、输出缓存
本书的 core.py 采用另一种接口:调用者把缓存传给 forward(ids, caches, return_cache=True),再接收返回的新缓存。每层缓存是一对 [B,H,T,d] 张量,模型根据已有缓存长度确定位置偏移。请求状态由调用者持有,因而更容易看清哪份缓存属于哪个请求。
下面是这几步操作的示意片段,变量名经过简化:先读取旧缓存长度,再拼接新 K/V,最后选取与新增查询位置对应的 mask 行。
python
past = cache[0].shape[2]
k = torch.cat((cache[0], k_new), dim=2)
v = torch.cat((cache[1], v_new), dim=2)
mask = future[past:past + new_length, :past + new_length]
这个接口便于理解状态如何传递,但每次拼接仍可能分配新内存,不能据此认为它已经适合高效服务。推理时还应使用 no-grad,避免连同历史反向图一起保留。当前实现没有支持异步并发请求、不同长度 batch 的独立指针或自动分页缓存;这些都需要额外设计。
8.5 预分配减少重复分配,却引入容量管理
如果希望减少逐步拼接带来的重复分配,可以提前留好空间。上游优化版预分配形状为 [B,H,W,d] 的 K/V,其中 ptr_cur 记录下一个空位;空间不够时,先把旧内容左移、丢掉最早部分,再写入新内容。
左移也有成本。为了避免重叠赋值,源码先对源切片做 clone,因此仍然会产生复制和临时内存,不能把它当成零成本的视图操作。
这也带来了容量管理:batch 大小改变时要重新分配,单个输入块不能大于窗口。生成函数会把长提示按窗口大小分块 prefill,从而处理超过单次缓存容量的提示。不过,一旦丢掉历史,计算语义就变了,不能再宣称它等价于完整上下文模型。
固定源码还有一个需要留意的类型边界:预分配 torch.zeros(...,device=x.device) 时,没有显式传入 dtype=x.dtype。默认 float32 路径与这里的缓存类型一致;如果把模型改为 float64 或半精度,缓存 dtype 未必跟着投影结果改变,可能出现类型不相容或精度变化。通用实现可以用 keys_new.new_zeros(...) 创建缓存,或者明确指定 dtype。本章所述上游优化版的小配置检查采用 float32,本轮没有重新执行。
8.6 丢弃 K/V 不等于重算截断窗口
为什么丢弃历史会改变结果?假设窗口只保留最近四个位置。可以直接保留这四个位置已经算好的高层 K/V,也可以取出最近四个原始 ID,从第一层重新算。前一种做法里的高层表示可能还携带更早的上下文信息;后一种做法已经去掉了那部分输入,而且可能把位置重新编号为 0—3。两者的输入表示和历史依赖不同,通常不会得到相同 logits。
因此,检查缓存是否等价时,应先保证“不发生丢弃、没有位置溢出”。原稿记录了一组上游三版模型的小配置结果:相同权重、长度 6、窗口 12 时,朴素和优化缓存相对无缓存基线的最大 float32 误差均为
这组数字原来指向 qa/core_training/cache_probes.json,但当前交付基线中没有该结果文件,本轮也没有重新执行,所以这里保留为待复核的历史记录。现存脚本确实设置了上述等价比较和窗口丢弃反例,但仅阅读脚本不能确认具体误差值。窗口丢弃本身会改变模型可见的信息,遇到这种差异时,应先检查语义,而不是直接放宽容差。
8.7 绝对位置容量仍是硬限制
除了缓存窗口,还要检查绝对位置 embedding 表的容量。窗口变小只会减少保存的 K/V,不会让位置表变长。优化版显式检查累计位置不超过 context_length,生成时还把新 token 数限制为 context_size - prompt_length。
本书的小测试脚本据此设置了一个检查:提示长 6、上下文容量 10、请求生成 20 个 token 时,断言只增加 4 个,并保留输入前缀。这个预期与固定源码的限制一致;由于对应结果文件缺失,这里不把它表述为本轮已运行通过的结果。
从计算依赖看,最后一个预测出的 token 不一定还要送回模型,因此上游循环会跳过它之后的多余前向。结合这一点看,源码采用的是一个保守的生成容量限制,并没有实现自动无限滚动。若希望继续生成,就要重新设计位置与缓存策略,再验证结果是否仍符合预期。
8.8 计算量与存储要分开算
在不截断的长度
普通 MHA 的缓存元素数为
少算了多少,还不能直接等同于快了多少。实际耗时会受矩阵大小、内存分配、同步、设备带宽和内核调用影响;对小模型来说,Python 和分配开销甚至可能占主要部分。上游 README 中特定 Mac 的性能结果属于上游实验,本书没有复测,不能把其中的加速倍数推广到所有 CPU/GPU。
8.9 怎样把等价检查写完整
配套代码把检查分成两组。run_checks.py 对本书模型比较完整前向、逐 token 缓存,以及先三个 token、再三个 token 的分块缓存。现存 qa/core_training/results.json 记录的 float64 最大差分别约为
另一组 cache_probes.py 抽取上游三版模型定义,用小配置检查单 token、分块、重置、容量限制和窗口丢弃反例。当前基线保留了脚本和固定源码,但缺少对应输出文件,需要重新运行后才能确认本章前面保留的历史数字。
上游 tests.py 比较三版生成 ID,还检查位置溢出和提示分块。不过,生成 ID 相同只能说明最后选中了同一个 token,不能保证 logits 足够接近,所以最好同时记录 logits 的最大误差。重置测试可以发现跨请求污染;容量测试则应检查实际返回长度,不能只看程序有没有崩溃。小配置测试也不覆盖多请求并发或真实 GPU 性能。
准备好运行环境后,可以在本书目录运行下面的命令,生成缺失的检查结果。命令会写入指定 JSON 文件;运行后应先阅读输出,再更新本章中的历史记录。
bash
python examples/core_training/cache_probes.py runtime_sources/upstream qa/core_training/cache_probes.json该脚本要求已准备好的固定源码,不会下载词表或权重。
8.10 练习与答案
补充题一:已有 5 个缓存 token,一次新增 3 个,允许 mask 的三行各有几个 True?答案:6、7、8。
补充题二:为何普通训练中更新参数后不能继续复用旧缓存?答案:旧 K/V 是旧参数和旧中间表示的函数,新参数改变了这些值,复用会跳过应有的重新计算和梯度路径。
补充题三:缓存只保留最近 100 个位置,是否说明模型可以使用绝对位置表生成第 10,000 个位置?答案:不能,缓存容量和位置表容量是独立限制。
参考与覆盖
- 无缓存、朴素缓存、优化缓存脚本:复用的 LayerNorm/GELU/FFN 见第 6 章,新增状态与生成路径在本章逐项解释。
- 上游测试:等价、位置容量、分块 prefill;本书以小配置新增 logits 与反例检查。
- 上游图片与硬件计时没有复用,本章图为原创。计算预算、现存结果记录和缺少输出文件的历史数字已分别说明;本轮未重新运行模型或硬件性能测试。
交互实验:KV cache 的计算复用
每来一个 token,哪些工作要重做?
固定输入 3 个 token,再逐个处理 8 个已给定的 token。对比开关缓存后的计算量,再看 KV 头数怎样改变缓存占用。
这里只数 K/V 投影的位置数,不执行语言模型,也不测量速度。
01
设置 · 同一步对比两种做法
每层 KV 头数
查询头数固定为 12固定条件:批大小 1、12 层、每头维度 64、每元素 2 字节。改变 KV 头数不会改变本例的位置计数。
02
过程 · 先算提示词,再逐个加入新位置
- Prefill当前 · 处理 3 个提示词位置
- Decode待开始 · 每次加入 1 个 token
步骤 0 / 8
本步计算 3 个位置的 K/V,复用 0 个旧位置。最新位置的 Q 仍要读取全部 3 个位置的 K/V,才能预测下一个 token。
本步新算 K/V3位置数 · 每层需要做投影的位置
本步复用 K/V0位置数 · 从前一步缓存中取得
最新 Q 的读取范围3位置数 · 缓存不省掉历史 K/V 的读取
当前上下文中的 K/V
实线:本步计算;虚线:缓存复用位置卡可横向滚动;手动滚动会暂停播放。键盘聚焦下方区域后,用左右方向键查看。
- 位置 1新算 K/V
- 位置 2新算 K/V
- 位置 3新算 K/V
03
结果 · 分开看重复计算与缓存空间
累计计算的 K/V 位置数3每层 · 从 Prefill 到当前步骤累计
缓存张量占用108.0 KiB全部 12 层 · 只计跨步骤保留的 K/V
试着在 Decode 阶段切换缓存。上下文长度不变,新算的位置数会改变。再切换 KV 头数,观察缓存占用;这里没有把位置数换算成速度。
内存怎么算?这个演示省略了什么?
稠密、未量化、完整上下文的缓存有效数据量为:2 × B × L × Hkv × T × D × s 字节。2 表示 K 与 V;批大小 B=1,层数 L=12,KV 头数 Hkv=12,已缓存长度 T=3,每头维度 D=64,每元素 s=2 字节。查询头数固定为 12。1 KiB=1024 字节。
数值不含模型权重、Q、注意力工作区、内存分配对齐或预分配空位。关闭缓存时,“0”只表示没有跨步骤保留的 KV cache,计算仍需要临时 K/V 内存。MLA、滑动窗口、量化缓存、分页管理等不能直接照搬这组假设。
不使用缓存的基线在每一步重新运行整个前缀。图中只展示最新位置的 attention 读取范围;它没有把整个模型的 FLOPs、耗时或显存画成等比例。缓存减少重复计算,但不消除对历史 K/V 的读取。
不操作也能读懂:prefill 建立缓存;decode 只补上新 K/V,再让新 Q 读取历史与当前 K/V。
依据:Transformers:How caching works。本页为简化教学模型。