主题
第 09 章 GQA、MLA 与跨层 KV 共享
生成一句话时,模型每次只增加一个 token,却要反复读取历史的 key 和 value。第 08 章用缓存避免了重复投影,但历史越长,缓存本身就越大。本章接着问:这些历史信息,能不能少存一些?
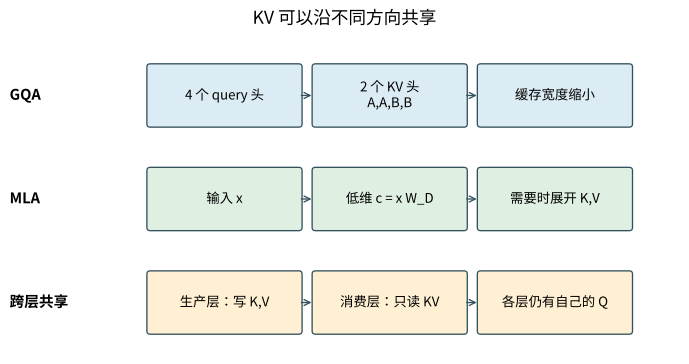
GQA、MLA 和跨层共享分别从三个方向入手:GQA 减少 KV 头,MLA 减少每个 token 的存储维度,跨层共享减少独立保存 KV 的层数。这样做也改变了模型能独立表示哪些信息。因此,它们都不是可以随手打开的推理开关;对任意已训练的 MHA 模型直接换用这些结构,不能期待输出保持不变。
本章源码基准为固定提交中的 GQA、MLA 和 KV sharing。以下推导和小实验为本书原创。阅读结果时要分清来源:上游的随机模型生成和 GPU 时间不属于本书实测;正文保留的实验误差也不能当作速度或语言质量的证据。
09.1 先把缓存账算在正确的对象上
设批量为
例如
09.2 GQA:多个问题,可以共用一套历史记录
令 KV 头数为
源码 GroupedQueryAttention.__init__ 用 num_kv_groups 表示 KV 头数,建立输出宽度为 num_kv_groups * head_dim 的 W_key 和 W_value。forward 先缓存未展开的 KV,再用 repeat_interleave(group_size, dim=1) 对齐 query 头。若两个 KV 头记作 A、B,四个 query 头应读取 A、A、B、B。若误用 repeat,排列就成了 A、B、A、B。张量形状完全一样,却把 query 头配给了不同的 KV 头;仅检查形状,发现不了这个错误。
一个容易混淆的细节来自同目录的估算器:其 CLI --n_kv_groups 用作 每个 KV 头分摊的 query 头数,以 n_heads // n_kv_groups 推出 KV 头数。同名参数在两处指向不同的量,不能把估算器的命令行参数原封不动搬入模型字典。记笔记或改配置时,先明确写出
缓存推理时,ptr_current_pos 决定 query 的绝对位置;此时若对一个 reset_cache 同时清空 K、V 和位置计数;新请求如果只重置其中一个,会产生跨请求污染或位置错位。
09.3 MLA:先存一个低维向量,需要时再展开
GQA 让多个头共用 KV,MLA 则进一步改变缓存中保存的表示。教学版 MLA 令潜在宽度为
其中
源码 MultiHeadLatentAttention.forward 的顺序很重要:先对新输入产生 query 与 latent_new,把 latent 追加到 cache_c_kv,再对 全部历史 latent 执行 W_UK、W_UV。这段实现减少了跨解码步保存的数据,但计算时仍会形成完整的 KV 临时张量,而且每个解码步都要重新上投影历史。于是,cache_c_kv.numel() 只能描述潜在缓存的元素数,不能代表整个注意力的峰值内存;字节数减少了多少,也不能直接换算成速度提升。
对一个头,暂忽略偏置与位置旋转,有
先把 query 投到潜在空间,再与
本书的 latent_and_sharing() 同时检查
09.4 跨层共享:消费者仍然提问,生产者负责写入
设只有
教学脚本 MultiHeadAttentionWithKVSharing.forward 接收 shared_kv。它为 None 时执行 K/V 投影和追加,并返回 new_shared_kv;非空时只读传入张量,返回的新共享值为 None。GPTModel.forward 顺序遍历 ModuleList:前
生产者交出的 KV 已经包含当前 token,消费者若再追加一遍,每步历史长度就会增长两次。共享还要求消费者只读:就地旋转或修改 key,会同时改变其他层正在读取的对象。本章小例检验三位消费者的 data_ptr 相同,再改变 query,确认共享缓存仍能产生不同输出。
教学实现保留消费者的 W_key/W_value 模块。它们在共享分支中不参与计算,但仍可能占参数内存。所以,检查实现时要分别问清:有没有计算该投影,有没有缓存该层 KV,以及有没有保留该参数。前两项省下来了,不代表参数内存也随之消失。上游测试分别验证所有层生产时与 MHA 一致、只有生产层留下缓存、估算器用生产层数计费;这比只检查输出形状更有针对性。
09.5 从注意力接回 GPT:哪些步骤没有改变
三个目录中的 LayerNorm 仍沿特征轴计算均值与总体方差,GELU 使用 tanh 近似,FeedForward 保留扩展再投回的两层结构。TransformerBlock.forward 依次执行归一化、注意力、残差,再归一化、前馈、残差。这些步骤共同构成 GPT 主干;更换 KV 机制时,可以沿着它们核对,避免把注意力之外的改动混进比较。
GPTModel 的 token/position embedding 相加,最后归一化并经输出头得到 ModuleList 传递 use_cache,记录模型级绝对位置,并通过 reset_kv_cache 重置全部注意力层。generate_text_simple_cached 先处理整个 prompt,再仅处理新增 token;到上下文边界时要重建裁剪后的上下文,不能让绝对位置 embedding 越界。CLI 的 main、parse_args 负责组织运行,计时和设备峰值内存报告帮助观察执行成本。这些输出都不能用来判断模型的语言质量。目录里的 MHA 对照文件保持相同主干,差别集中在投影、缓存与掩码。
memory_estimator_* 的字节函数、参数校验、单位换算和 main 把 09.1—09.4 的式子变成命令行输出;plot_memory_estimates_* 在不同
09.6 可复现实验、练习与答案
完整可运行程序是 examples/architectures/architecture_checks.py,运行 python examples/architectures/architecture_checks.py。原稿注明的运行环境为 Python 3.12.14、PyTorch 2.6.0+cpu,seed 1949、单线程、float64,并将结果记在日志 qa/architectures/algebra_checks.json 中:GQA 分组与展开误差为 0,错误 repeat 被检出;MLA 两项最大误差为
补充练习。 ①
提示与答案。 ① 零基编号,repeat_interleave 的临时张量恢复了
若要从代数例子继续检查真实模型类,可以使用 source_attention_checks.py。它导入已审查的 GQA、MLA 和 KV 共享脚本,但不运行 CLI。原稿报告,GQA 与 MLA 的完整前向和分块计算误差均为 0;KV 共享三层模型的误差为 qa/architectures/source_attention_checks.json,当前文件中同样缺少这份历史记录。源码可以确认检查对象和断言,却不足以核实当时的精确输出。
参考资料与边界
- 固定源码:前述三个目录,逐函数映射见配套覆盖台账。
- Ainslie 等,GQA(2023):https://arxiv.org/abs/2305.13245。
- DeepSeek-AI,DeepSeek-V2(2024):https://arxiv.org/abs/2405.04434。
- Brandon 等,Cross-Layer Attention(2024):https://arxiv.org/abs/2405.12981。
- 未运行:大模型生成、GPU 内存/吞吐比较、从 MHA checkpoint 继续训练。