主题
第 19 章 从 GPT 到 Llama:RoPE、RMSNorm 与门控前馈
“把 GPT 改成 Llama”容易被误解成改几个配置数值。真正需要改变的是模型函数:怎样归一化、怎样表达位置、怎样组合前馈支路,以及如何把 checkpoint 的参数放到正确位置。形状对得上只是第一步,数值约定对得上才可能加载成功。
固定源码 ch05/07_gpt_to_llama 包括 GPT→Llama 2、Llama 2→Llama 3/3.1/3.2 和独立 Llama 3.2 三份 notebook。转换指的是逐步修改实现,不是把 GPT 权重无损变成 Llama 权重。本章不下载任何 pretrained checkpoint。
19.1 RMSNorm 保留均值,只调节整体幅度
LayerNorm 对长度为
[2,2,2],LayerNorm 在无 affine 情况下输出全零;RMSNorm 输出接近 [1,1,1]。两者不可只按类名替换,然后沿用旧 checkpoint 期待相同输出。RMSNorm 原论文 给出这一归一化设计的动机与实验。
GPT→Llama 2 notebook 先定义 RMSNorm,与 torch.nn.RMSNorm 比较,再将其放入 block 的两个预归一化位置和模型末尾。独立 Llama 3.2 使用 PyTorch 模块;dtype、eps、参数初始化必须与来源一致。低精度时平方求和常提升到 float32,不意味着所有模型都可把归一化任意搬动。第 21、22 章会看到零中心权重、头内归一化和投影整体归一化的不同约定。
19.2 SwiGLU 的两个分支分别做什么
令
fc1/fc2/fc3 的次序要和 checkpoint 的 gate_proj/up_proj/down_proj 对应,不能因为前两个矩阵形状相同就随意交换。
不计 bias,参数为
19.3 RoPE 把位置变成二维旋转
绝对位置 embedding 把一个位置向量直接加到 token embedding。RoPE 则旋转 Q 和 K。先取一对坐标
头宽 cat([-x2,x1]) 实现旋转的垂直方向,cos/sin 表在两个半区重复。另一些模型使用偶数/奇数配对,公式相同,但需要相应置换投影权重。
关键性质来自旋转矩阵:
所以点积通过位置差进入。旋转保范数,但这不等于注意力完全不含绝对位置信息,因为输入表示、边界和可见历史仍有区别。RoFormer 给出了该位置编码的定义。通常不旋转 V,因为输出被聚合的是内容表示。
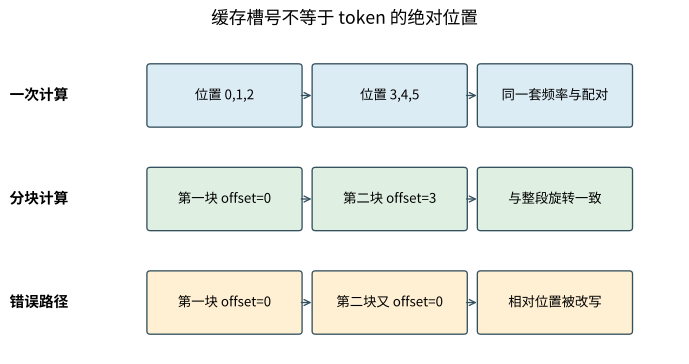
precompute_rope_params/compute_rope_params 产生 compute_rope/apply_rope 将它们广播到
19.4 Llama 3 的 GQA 与长上下文频率
Llama 3 的注意力改用 GQA,query 仍有 GroupedQueryAttention 把 mask 与 RoPE 参数作为共同输入;TransformerBlock 顺序执行预归一化注意力与预归一化门控 FFN;Llama3Model 管理 token embedding、共享位置表、因果 mask、最后归一化与词表输出。
调整 RoPE base 影响各维频率,不能简单理解为“把最大长度改大”。Llama 3.1/3.2 的 freq_config 进一步分段缩放。设原上下文长度为 low_freq_factor/high_freq_factor 给出:长波长的低频降频,短波长高频保留,中间频率平滑插值。源码先构造缩放频率,再用 is_medium_freq 对中间带替换。这个频率修改改变所有后续位置角度,不能先缓存旧 key 再中途换规则。
缓存扩展时,新 token 的 RoPE 位置应从已处理长度开始。独立 Llama 3.2 这份 notebook 本身是无 KV-cache 实现,不能直接只输入最后一个 token 来“加速”。本书原创 rope_cache_offset 测试演示正确 offset 与错误从零重启的区别;缓存版具体接口在第 20 章对照。
19.5 分词器、对话边界与权重布局是一整套协议
Llama 2 notebook 的 LlamaTokenizer 包装 SentencePiece;Llama 3 的 Tokenizer 用 tiktoken 加载指定 mergeable ranks,并加入 BOS/EOS、header、回合结束等特殊 ID。encode 的 BOS/EOS 开关和 ChatFormat 的角色 header 决定输入协议。不要把“都是 BPE”当成可共用词表;同一个 ID 在不同词表里可能代表不同字节。clean_text 只清理显示输出,不能代替正确的停止 token 处理。
assign 在 no-grad 下核对源/目标 shape 并复制,避免静默广播;Llama 2 的 permute 处理 RoPE 配对布局与 checkpoint 的投影约定。这一 Llama 2 加载器还有一个配置边界:函数内部把 cfg 固定为全局 LLAMA2_CONFIG_7B,Q/K 的 permute 使用其中的头数和宽度,而层循环读取传入的 param_config。因此传入小模型或其他尺寸配置,并不会同步改变所有重排尺寸;移植时应统一从实际配置取值,并加入非默认尺寸的布局检查。
转换时除 Q/K/V/O 外,还须映射三份 FFN 权重、两个 block norm、final norm、embedding 与 output head。错误交换同形状矩阵不会触发 shape 错误,最好加入一层输出的来源对照;本书没有下载权重,因此没有做 checkpoint 级一致性声明。
Llama 3.2 的词嵌入和输出头可以共享参数。count_unique_parameters 按存储身份去重,区别于把两个名称下的元素数简单相加。共享要求 out_head.weight 与 tok_emb.weight 指向同一个 Parameter,复制数值不等于绑定。calc_model_memory_size 统计参数、梯度、buffer 的字节,只是特定假设下的预算,没有包括每种优化器状态和完整训练峰值。
目录的 config.json 是认证配置模板,不是模型权重配置;本书不要求把令牌写进文档或源码包。登录、许可确认、Hub 下载以及 safetensors 合并单元均只做静态讲解。源码公开许可不等于模型权重许可,访问权重仍需遵守发布方条款。
19.6 主干外的辅助步骤与源码差异
previous_chapters.py 提供 GPTDataset、滑窗 dataloader、GPT 基线、采样、交叉熵、验证、训练与绘图等复用函数。它们使 notebook 可以逐步比较旧主干和新主干;数据集将输入与目标错开一个 token,loss 展平为
三份 notebook 有意重复类定义,独立版删去转换演示与旧配置,保留一套完整 Llama 3.2 前向、分词、权重加载和生成。import_from_notebook 从前一 notebook 读定义用于递进演示,本书不运行这个入口,因为全本执行可能触发下载和大模型分配;测试只白名单执行已审查的架构定义单元。
19.7 真实检查、练习与答案
examples/architectures/architecture_checks.py 的 RoPE 测试证明整段/分块位置一致、范数保持和相对位移恒等式;误差不超过 examples/architectures/source_smoke.py 另外执行独立 notebook 单元 6—10 的真实类定义,在词表 31、宽度 16、两层、上下文 16 的缩小配置上产生 qa/architectures/source_smoke.json。此处是随机参数、CPU 结构检查,不是 Llama 语言能力测试。
补充题。 ① [2,2,2] 能区分 RMSNorm 和 LayerNorm 吗?② 前半/后半与偶奇配对为什么不能只改旋转函数?③ 扩词表后怎样保持 weight tying?④ 把 RoPE 表长度扩大十倍是否证明长文效果可靠?
答案。 ① 能,前者保留非零均值。② Q/K checkpoint 的坐标布局必须同步置换。③ 重新绑定同一个 Parameter,并检查优化器引用,见第 23 章。④ 只能避免索引越界;质量还依赖训练、频率方案与验证。
19.8 上游测试怎样把错误定位到零件
tests/test_llama32_nb.py 用 import_notebook_defs 只导入定义,dummy_cfg_base/dummy_input 建立小配置,再做形状检查;可选 Transformers 对照先建立随机参考模型,再把它的 state_dict 交给本实现加载器,比较 logits。两边必须使用同一份权重;各自随机初始化后比较没有意义。
tests_rope_and_parts.py 另保留 LitGPT 的 litgpt_build_rope_cache/litgpt_apply_rope 参考函数及其 Apache 来源声明,比较 Llama 2、3、3.1/3.2 的旋转表与应用结果。局部 RoPEConfig.standardize_rope_params 适配 Transformers 不同版本的配置接口;set_seed 固定随机性;test_silu/test_rmsnorm 对比 PyTorch 基础算子。测试中的 notebook 导入 helper 只提取所需定义,不能据此许可执行后面的登录/下载单元。当前环境没有 Transformers 或 pytest,本书未运行这些上游参考对照,仅运行前述自包含代数与真实类 smoke 检查。
参考资料
- 固定源码
ch05/07_gpt_to_llama,所有 notebook 单元及 Python 定义见覆盖台账。 - RMSNorm:https://arxiv.org/abs/1910.07467;GLU variants:https://arxiv.org/abs/2002.05202。
- RoFormer:https://arxiv.org/abs/2104.09864。
- Llama 2:https://arxiv.org/abs/2307.09288;Llama 3:https://arxiv.org/abs/2407.21783。
- 未运行:认证/权重下载、全尺寸分配、预训练、checkpoint 输出对齐和长上下文质量评测。