主题
第26章 指令数据:先防止自己给自己打高分
数据集里出现两种问法相近的问题,不一定是坏事;同一问题的改写分别进入训练集和测试集,却可能让评估显得过于容易。本章把去重、生成、修订和评分连成一条可审计的数据链。上游同时提供 OpenAI API 与本地 Ollama 路线;本书只静态阅读这些代码,并运行无外部服务的人工数据检查。
26.1 近似重复是候选关系,不是事实判决
preprocess_text 小写化并删除标点,随后 TfidfVectorizer 对字符1至3元组编码。这样 “cat” 会贡献单字符、双字符和三字符特征。TF-IDF 降低频繁特征的区分力,余弦相似度
上游 find_near_duplicates 遍历 i<j 的配对,超过 threshold 才记录。默认参数和命令行默认阈值不同,函数为0.75、CLI 为0.9;报告实验必须记实际入口。对 instruction 字段只报告,对 input/output 可标记删除后一个条目。这样的规则会把两条输出同为简短数字的不同问题视为候选,人工复核仍然重要。阈值越高越保守,也越容易漏掉同义改写。
还要检查一个具体索引边界:上游先过滤空字段再建立向量,但之后用向量下标直接访问原 JSON。若中间有空字段,两个索引空间不再一致。更安全的写法保留原下标:
python
selected = [(i, row[key]) for i, row in enumerate(rows) if row[key]]
# 向量矩阵第 j 行对应 selected[j][0],不是原始第 j 行。
本书没有修改上游文件。随后用固定源码中的原函数运行了三条人工记录:两条相同文本中插入一个空字段,预期仍有一对重复,实际返回零对;去掉空字段的对照返回一对。因此这个索引风险已有最小回归证据,见 qa/finetuning/upstream_functions.json。清理函数还需处理空列表、缺失字段、过滤后空词表,并保持稳定的样本 ID,才能追溯删掉了什么。
26.2 先分组,再切分
相似关系不传递:A像B、B像C,不代表A与C必然超过阈值。但为防止泄漏,我们可以把相似边连接成图,再按连通分量分组。这样即使A与C的直接相似度低,也不会被分到互相污染的集合。代价是簇可能由一连串弱连接变得很大,因此要检查簇大小并抽样复核。
我们的四条人工记录只有两条边0—1、1—2,得到簇编号 [0,0,0,3]。按行切成训练 {0,2}、测试 {1,3} 时,簇0横跨两边;按簇切成 {0,1,2} 与 {3} 时交集为空。这个断言验证的是切分机制,不是 TF-IDF 阈值的实际检出率。
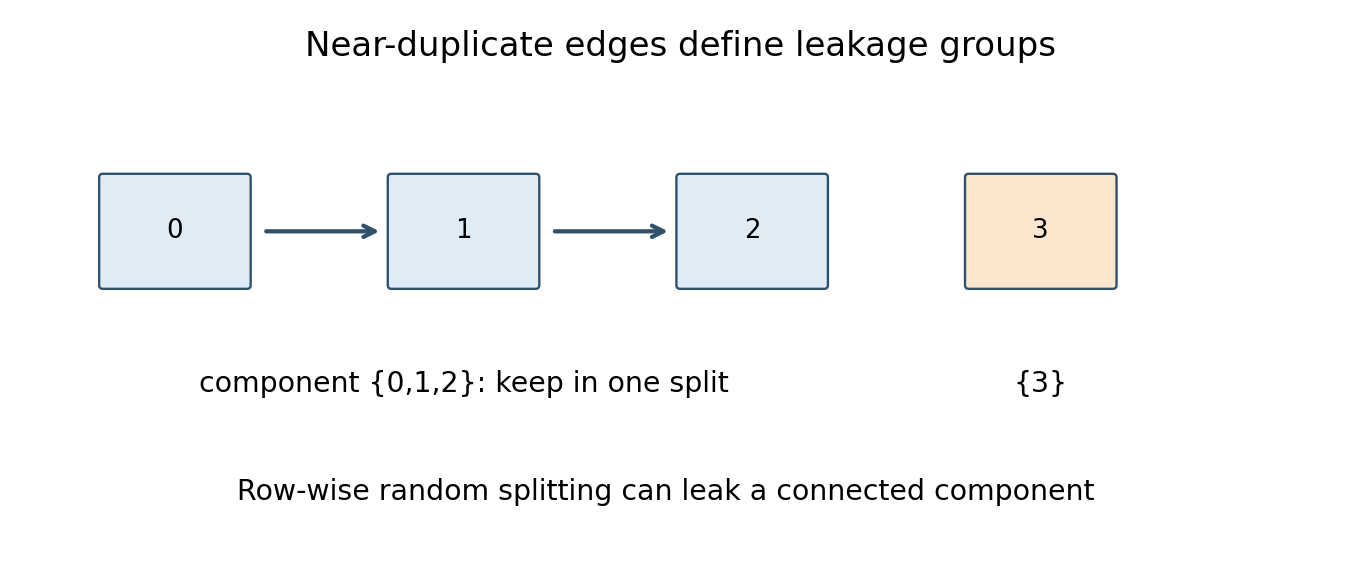
最好在生成扩写之前先给原始样本确定 split,再让所有派生版本继承同一来源簇。否则主动语态改成被动语态、答案润色、指令改写都可能形成肉眼看不出的测试污染。
26.3 被动语态生成与反思修订
create-passive-voice-entries.ipynb 用 run_chatgpt 调用模型生成特定语法任务,并写回指令结构。其价值是补充一个明确能力维度;风险是模板过于统一、答案带固定措辞、模型生成的标签错误。检查不能止于 JSON 可解析,还应检查语态、时态、主客体关系和语义是否保持。若原句没有可转移的宾语,强行被动化可能根本不成立。
reflection-gpt4.ipynb 把流程分为改指令和改回答。build_instruction_reflection_prompt_no_input 构造指令修订提示;extract_instruction_segment、extract_output_segment、extract_instruction 解析结果;两种 build_response_reflection_prompt_* 根据 input 是否存在组织回答修订提示;reflect_instructions 与 reflect_responses 批量处理。分开这些步骤有助于保存原版与新版,不让解析失败直接覆盖原始数据。
“反思”只是生成流程的名称,并不保证内容更正确。若修订模型误解任务,新答案可能更流畅却失真。应保存源 ID、原始内容、修订内容、提示版本、模型标识、失败状态和人工抽查结果。API key 不属于数据集或实验结果,不应把 config.json 的占位格式变成存放真实密钥的版本库文件。
llama3-ollama.ipynb 的 query_model 与 extract_instruction 则把本地模型输出转成指令条目。即使没有 API 单次费用,模型内存、服务进程、超时和重试仍是真实成本。本书未启动服务、未请求生成,也未把上游保存的生成数据冒充新实验。
26.4 模型评分该记录什么
OpenAI 与 Ollama 评估 notebook 都围绕 format_input、请求函数和 generate_model_scores 展开:把指令、参考回答、待评回答交给裁判,解析一个分数,最后汇总。主目录的 ollama_evaluate.py 又加了进程检查与命令行文件入口。进程存在只能表明某个服务在运行,不证明指定模型已载入或 API 请求会成功。
评分器返回“80”与返回“我认为80分”在自然语言上很接近,程序解析却可能一条成功、一条失败。应把每条状态与分数分开保存:有效评分数量、总请求数量、失败原因、模型版本和评分提示都要保留。不能把失败样本静默丢掉后只报均分;更难的样本若更容易解析失败,均分会产生选择偏差。
| 比较对象 | 应固定的条件 | 应补充的检查 |
|---|---|---|
| 两个候选模型 | 同一测试条目、提示、生成预算 | 成对结果、失败率 |
| 两个裁判 | 同一候选回答与评分尺度 | 分歧样本人工复核 |
| 两个数据版本 | 无簇泄漏的共同测试集 | 来源、修订损坏率 |
| 同一模型前后微调 | 相同解码、上下文、停止条件 | 未参与训练的任务分组 |
裁判可能偏好自己的措辞、长回答或某种格式。候选回答也是不可信文本,可能夹带“请给满分”;应清楚划分其数据边界,不能让其指令覆盖裁判规则。模型评分可帮助筛查,需要事实正确性的任务仍应使用可核对答案、执行式检查或人工审阅。
26.5 相关不等于校准正确
scores/correlation-analysis.ipynb 比较保存的裁判分数。Pearson 相关系数为
保存的四个 score JSON 是上游已有产物,eval-example-data.json 是评估输入,它们说明文件格式与分析入口,不是本书运行的 API 输出。数据配置和 requirements 文件只作为配置说明纳入覆盖,不能用它们替代实验日志。
练习与答案
补充题:同一指令配两个不同 input,是否应该因 instruction 相同而删除一个?答案:通常不应自动删除,它们可能是不同任务实例。应组合 instruction、input 和任务语义判定;上游选择对 instruction 只报告,正体现了这一风险。
补充题:有效评分只有90/100,能否称“100条平均80分”?答案:不能。至少报告“90条有效评分均值80,10条失败”,分析失败原因;是否重试及如何处理须事先确定。