主题
第 11 章 Gated DeltaNet:从矩阵状态理解递推
生成文本时,如果把历史信息压进一个固定大小的矩阵,状态就不必随着序列变长而不断扩张。但这样一来,新信息该写到哪里,旧信息又该怎样读取和修正?Gated DeltaNet 用一套递推规则解决这些问题。理解它,需要先看矩阵怎样更新,再看这种记忆方式与 softmax 注意力有哪些区别。
本章沿固定提交的 Gated DeltaNet README 与估算脚本 展开。核心模块写在 README 的代码块里,独立 Python 文件则负责内存估算与绘图。阅读时应先看 README 中的模块,再看估算脚本,不能只按文件数量判断实现范围。完整含卷积的 Qwen3.5 模块在第 20 章继续解释。Gated Delta Networks 原论文 是递推规则的研究来源。
11.1 一个 key 对应一行读出方向
先只看一个 batch 样本中的一个头。令 key/query 宽度为 k_t @ S。读出
先考虑简单外积累加
11.2 Delta rule 用预测误差修正记忆
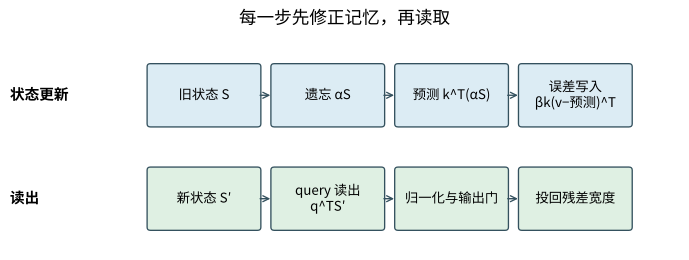
以下先按每个头使用标量写入门来推导。先用遗忘系数衰减旧状态,即乘以
再用当前 value 减去预测值,得到需要修正的误差。把误差乘以写入强度
本章示例把
这条规则还可以从瞬时平方误差理解。把
取 [3,4],第二行不变。因为
11.3 源码每一步的形状与顺序
README 的示例从
Q 作 L2 归一化后再除以 S = x.new_zeros(B,H,d,d) 与输入保持设备和 dtype。
时间循环里,S = S * a_t 必须放在 kv_mem 的计算之前。这样,当前 value 比较的是衰减后的预测,而不是衰减前的旧预测。(S * k_t.unsqueeze(-1)).sum(dim=-2) 沿 key 维求和,得到 k_t.unsqueeze(-1) * delta.unsqueeze(-2),产生 unsqueeze 颠倒,得到的外积方向也会颠倒。状态恰好是方阵时,形状检查可能放过这个错误,程序能运行却不代表更新方向正确。
输出沿 query 方向读取,所有时间结果堆叠后转成
README 为了集中说明递推,省略了局部卷积。这个简化接口也不会跨 forward 调用保存状态:每次调用都重新建立零矩阵,因此若只喂入最后一个 token,就无法利用之前的历史。流式实现需要返回本次的最终状态,在下次调用时把它作为初始状态;切换到不同请求时,还要重置状态,避免混入另一条序列的记忆。Qwen3.5 的 cache 正是为此增加另一套协议。
11.4 为什么可以分块,为什么仍不能称为任意 softmax 的等价替代
先沿用前面标量写入门的简化设定,将递推改写为
从零状态展开有
乘积从右到左依时间顺序作用,先发生的更新先乘,不能任意交换。这里能分块,是因为仿射映射的组合满足结合律:可以先合并一段更新,再与另一段合并,但每段内部的时间顺序必须保留。
对于 README 中逐 value 通道的写入门,需要按状态的列分别理解这种仿射更新,不能直接把向量门代入上面的单一左乘矩阵。学习时可以先用慢速展开核对标量版本,再研究 chunk kernel 如何利用块内的三角结构。
固定大小的状态把历史压缩到同一个矩阵空间,不同历史可能得到相同状态。它没有逐个保存历史 key/value,因此之后无法再随 query 对每个历史 token 重新分配 softmax 权重。这是压缩记忆的表达限制,不能靠修正某个实现 bug 消除。混合模型保留部分全局注意力层,用两种记忆方式承担不同职责,具体效果仍需训练与质量评估。
11.5 存储与计算的边界
这里只比较推理时保留的状态,设每个元素占用的字节数为 s。每层矩阵状态占
plot_memory_estimates_gated_deltanet.py 用配置计算 MHA 和固定状态、再按混合比例相加。曲线来自公式估算,没有计入卷积缓存、模型权重或训练反向传播所需的中间状态,也不代表 GPU 显存实测。训练还需要保存、重算或按块组织中间量,因此“推理状态不随序列增长”不能直接推成“训练内存也不随序列增长”。
11.6 真实验证与补充练习
完整程序 examples/architectures/architecture_checks.py 的 delta() 用 6 个 token、3 维 key/value,对照逐步递推与逐项展开。原稿报告的 float64 最大误差为 qa/architectures/algebra_checks.json,但当前交付目录未包含这份日志,暂时无法核验这些历史输出。本轮只核对了测试代码,没有重新执行,也没有运行论文训练实验。
题目。 ① v - prediction 改成 v 会发生什么?④ 为什么 Q/K 不等宽于 V 时更容易检查转置错误?
答案。 ① 只剩当前写入
参考资料
- 固定提交
ch04/08_deltanet/README.md中的模块、比较片段与绘图说明。 - Yang 等,Gated Delta Networks:https://arxiv.org/abs/2412.06464。
- 完整 Qwen3.5 helper 的 chunk/recurrent 实现与卷积状态见第 20 章。