主题
第27章 DPO:比较两个回答,也要说明比较的基准
监督微调提供一个目标回答,偏好数据提供一个排序:同一提示下,回答 y⁺ 比 y⁻ 更合适。DPO 把这种排序变成可微目标。要写对它,必须先分清四组对数概率、序列归约方式,以及参考模型为什么保持不变。
27.1 偏好对不是两个独立分类样本
数据条目包含 instruction、input、chosen、rejected。两段回答共享提示 x,否则偏好差异可能只是题目难度差异。create-preference-data-ollama.ipynb 的 generate_model_responses 请求本地模型产生偏好材料,format_input 仍维持指令格式。自动生成的 chosen 标签只表达构造流程的偏好假设,不等于已经有人工共识。来源:偏好数据生成
PreferenceDataset 分别保存 prompt、chosen 完整序列和 rejected 完整序列。collate 在两种回答之间找共同最大长度,形成两个 B×T 输入与两个布尔掩码。提示不应因“也在完整序列里”就自动进入回答分数;padding 更不应进入。截断后若某个回答没有有效 token,这一对必须被拒绝或重新准备。
27.2 从受约束奖励到概率比
固定提示 x,设策略
并约束
把与 y 无关的常数吸收到归一化量 Z(x),可得
在同一个 x 下比较 y⁺、y⁻时,
令
单条样本的四个 l 都是标量;batch 中分别是形状 B 的向量,最后按样本平均。
27.3 为什么要用稳定的 logsigmoid
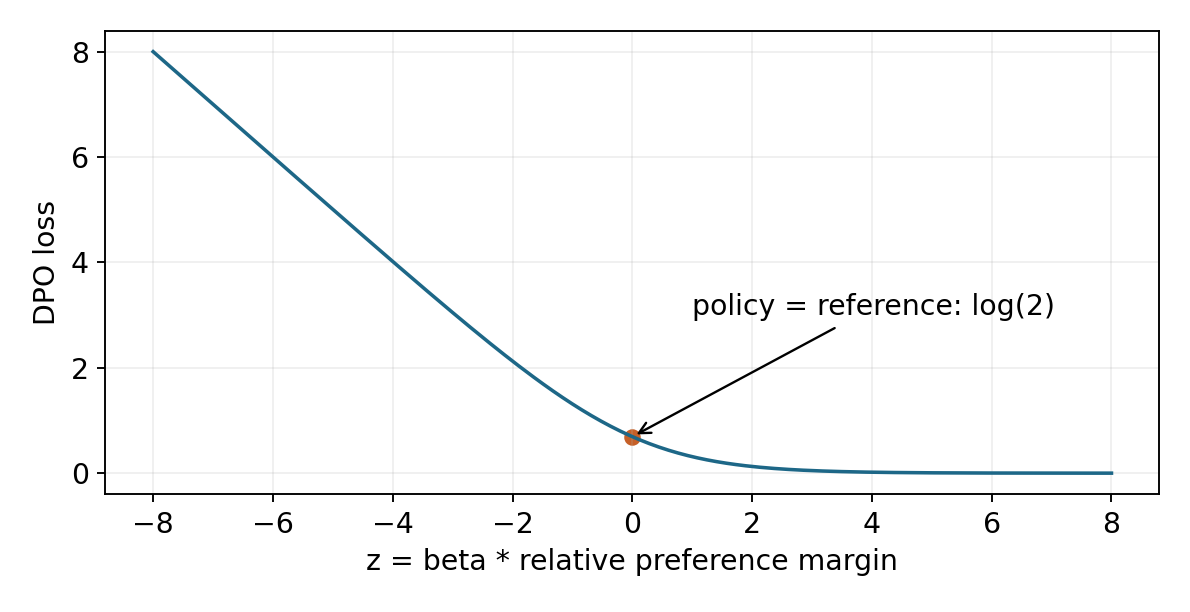
直接计算 -log(sigmoid(beta * delta)) 在很大的负输入下可能先把 sigmoid 下溢为0,随后出现无穷。等价写法是 softplus(-beta*delta) 或 -F.logsigmoid(beta*delta),避免不必要的中间概率。
python
margin = chosen - rejected - (ref_chosen - ref_rejected)
loss = F.softplus(-beta * margin).mean()
导数
人工极端例得到有限 loss 1000.34657359028,而直接 -log(sigmoid(-2000)) 为无穷。参考张量的梯度保持 None。实验没有训练大语言模型,只验证稳定数值与梯度归属。
27.4 从 token logits 取得回答分数
模型输出 logits[:, :-1] 与 ids[:, 1:]。先在 V 轴做 log_softmax,再 gather 真实 token 对应项,得到 B×(T−1)。掩码也必须同步取 mask[:,1:],否则提示/回答边界错位。
python
logp = logits[:, :-1].log_softmax(-1)
token_logp = logp.gather(-1, ids[:, 1:, None]).squeeze(-1)
answer_logp = (token_logp * mask[:, 1:]).sum(-1)
论文的序列概率分解给出 compute_logprobs 却在掩码求和后除以有效 token 数,得到 token 平均。这是长度归一化的实现变体,不能说成与原始序列 DPO 完全相同。源码:compute_logprobs 与 compute_dpo_loss
本书另从固定Notebook抽取原始 compute_logprobs 运行人工输入,确认返回token平均;全空mask实际产生NaN。因此补充实现选择显式拒绝空回答,而不是照抄除零路径。
均匀三词词表中,每 token log概率是−log3。两个回答分别有2与4个有效 token,则求和为−2.1972245773、−4.3944491547,平均都是−1.0986122887。长回答的序列概率较小并不自动意味着更差;改为平均消除了这一直接长度效应,也改变了优化对象。比较实验须明确使用哪一种,并保持策略与参考使用同一归约。
上游 collate 对提示长度额外加2,意图排除两个换行 token。这依赖具体 tokenizer 与拼接边界;BPE 对拼接后的分词未必等于各段独立分词的简单拼接。更稳妥的方法检查完整编码上的前缀稳定性,明确分隔符是否计入回答,并打印被掩码后实际评分的 token。
27.5 参考模型、训练与日志
compute_dpo_loss_batch 做策略 chosen/rejected 两次前向,并在 no_grad() 中做参考两次前向;compute_dpo_loss_loader 汇总评估;evaluate_dpo_loss_loader 切换模式;train_model_dpo_simple 负责优化和定期生成。参考模型应固定参数并处于 eval 模式,避免 dropout让同一参考回答的分数反复变化。策略评估也需 eval;训练后恢复 train 模式。
源码用于记录的 chosen/rejected rewards 是策略与参考 log概率差并 detach,没有乘 β。因此它们是诊断量,不能直接当成前面推导中带 β 的奖励。更重要的是观察 chosen 与 rejected 的差距、验证 loss和独立任务质量。偏好 loss下降不保证事实准确率提高:如果数据标签偏好冗长或讨好,模型也会认真学会这些特点。
把参考模型错误地一起更新,会让“相对固定基准”的定义失效;把参考概率 detach仍不足以保证参考权重不变,还要确保它不被其他优化器或共享参数修改。小实验只验证本地张量图,不验证模型克隆、参数共享或完整训练的显存需求。
练习与答案
补充题:策略和参考相同,β=0.1,loss应是多少?答案:log2≈0.693147,与每条回答自身概率无关。若不是,检查 dropout、mask、shift与权重是否一致。
补充题:chosen比rejected多两个 token,能否直接比较sum与mean实验的reward曲线?答案:不能。它们的量纲分别是每序列和每 token,对长度的响应不同,应分开标注。
来源
DPO 固定实现及训练循环;DPO 论文。数据 JSON 是上游已有偏好样本;本书未执行70B生成或任何Ollama请求。